视频生成与世界模型
探讨视频生成与具身机器人向物理仿真世界模型演进
1个信源参与该主题的先锋
全部段落
10月24日
10月13日
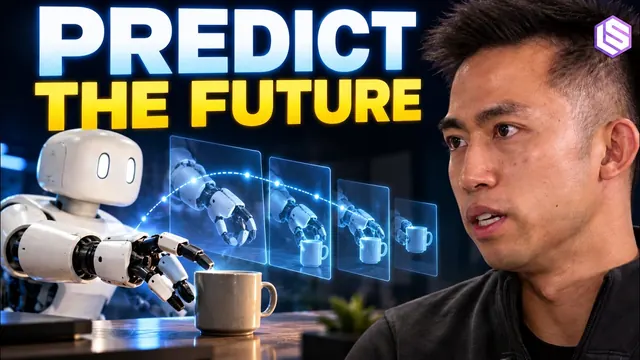
- Vibhu Jason称,技术路线押注于Dyna-2:这是首个以超过100万小时数据训练的“世界动作模型”。 它预测未来的视频或未来世界的表征,并以此引导动作。Jason将其比作“思维链”:模型在视觉和物理空间中推理,再输出动作。底层采用结合流匹配的扩散Transformer。Vibhu称,动作空间约有100维;模型每秒10–20次预测一个至少50维的向量。
- Vibhu指出,纯视觉世界模型可能存在模态缺失的问题。 他认为,视觉加触觉、数据效率高出100倍的模型可能是另一种方案,因为触觉信息可能比高度冗余的像素更密集。他还称,机器人公司可能比视频生成公司更适合增加感知模态。硬件同样是瓶颈:灵巧手可能很快过热。
10月2日
10月1日
9月27日
9月25日
- Anastasis Germanidis Anastasis Germanidis认为,没有证据表明世界模型需要绕道采用JEPA式架构。 他对Yann LeCun“理解世界的运行规律,与生成可爱视频截然不同”的说法回应得很直接:“它们是同一件事。”他指出,在Physics IQ基准中,固体力学、流体动力学和光学得分会随着模型规模和算力扩大而“可预测地提升”,但也提醒,视频模型可能作弊,当前表现很容易被过度解读。
- Germanidis认为,实时生成不是可选项,而是必然趋势:“如果2年后我们还不是主要使用实时模型,我会非常惊讶。” Runway的characters模型是一个以24 FPS运行、经过步数蒸馏的自回归头像模型;在他看来,这是“实时视频模型最大规模的部署”。扩散模型提供两条蒸馏路径:缩小模型,或将推理步数从50步降到4步,让许多场景下的前沿模型也达到实时表现。更低的服务成本叠加更好的用户体验,使 …
- Latent Space 本期最具扩张性的判断是:界面世界模型会把软件渲染为生成像素——“这里没有HTML、CSS、React……为什么要生成用于生成像素的代码? 直接生成像素就好。” 终局是“完全神经化的操作系统”;同一类模型还可以充当合成数据生成器和计算机使用Agent的实时RL环境,让这项技术突破创意工具的边界。
- Runway“意外地仅靠扩大视频模型规模,就造出了机器人领域的SOTA模型”,而其数据论也颇具分量:第三人称视频的数量比第一人称数据多3个数量级。 基于Gen 4.5构建的GWM-1,仅使用数百小时机器人微调数据,而机器人预训练通常需要数十万至数百万小时。Runway称,在RoboArena上,真实世界与仿真结果的相关性非常好,这意味着策略评估可以在仿真中扩展,而不必依赖硬件。
- 2024年2月的Sora时刻让Runway在“Runway完了”的喧嚣中经历了“数小时的存在主义危机”。 随后公司用3个月把模型规模和训练算力扩大10倍,从零开始建立模型并行能力,并在当年夏天推出Gen-3。这段韧性故事,加上最初在Series B阶段决定建设1,000张A100集群的“略显不理性”押注,构成了同一套模式:在证据出现之前下注,然后快速适应。
- Anastasis Germanidis 谈到竞争格局,Germanidis承认西方在视频领域落后:“排行榜前10名、前20名里,大多数模型都是中国模型。” 他与NVIDIA共同发起Cosmos Coalition,希望通过开放权重、物理基准和基础设施,把世界模型研究带入开放生态。他质疑长期依赖中国模型蒸馏的策略,认为这可能锁定性能上限;Runway则认为,不靠蒸馏也能训练出强模型。