AI集群硬件与网络物理瓶颈
分析互连网络、先进封装制造与芯片供应链的物理制约
5个信源 · ↑1.7×参与该主题的先锋
全部段落
10月27日
10月24日
10月23日
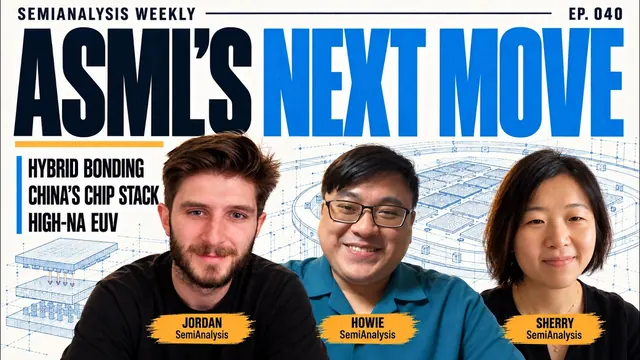
- SemiAnalysis ASML尚未公布的混合键合设备,将把其前道工艺的精度优势带入由Besi等贴装专业厂商主导的市场。 这一判断基于2025年的专利申请,设备部署还要“数年之后”。芯粒在准备和测量过程中始终放在传送载具上;ASML采取“让晶圆去找芯片”(the wafer to the die)的方式,在键合间距不断缩小之际发挥其计量和晶圆台优势。
- Howie 传送带设计能否实现量产良率,以及能否整合供应商,是ASML面临的关键执行问题。 键合需要六轴对准和无颗粒表面;一个污染物就可能撑开更大一片区域。Howie质疑移动中的测量头如何保持精度,以及数米长的轨道如何保持洁净;Sherry称相关要求“几乎相当于前道工艺”。
- 中国的逻辑折叠路线图,为混合键合设备带来了另一类需求。 Howie以一款华为手机及其分区设计为例,称其频率可达2.7 GHz;此外,路线图还瞄准了全混合键合的数据中心加速器,甚至计划到2030年实现3层堆叠。相关良率下降意味着“要用更多设备,才能得到同样的良品产出”,体现了中国在工艺受限下继续推进扩产的努力。
- 技术路径分化最明显的证据,已经体现在芯片设计上。 Howie对比了AMD的缓存堆叠与华为将核心内部组件分布到不同层的做法。Sherry认为,国内化正从政府主导转向晶圆厂与供应商协作;出口管制“可能加速”这一进程,但她没有预测政策走向。
- Sherry Zhang 更大的High-NA掩模版将恢复完整曝光场面积,并支持ASML提高设备售价。 计划在2030年前后采用的6×12英寸掩模版,旨在突破目前约400 mm²的半场限制,恢复至850 mm²;这要求掩模版生产、防尘膜、检测和搬运环节同步调整。Sherry将吞吐量提升与ASML的“基于价值的定价”联系起来;要实现这一收益,整个供应链必须协同推进。
10月22日
- Dwarkesh Podcast 现有设备可能只能支撑先进制程晶圆产出约翻一倍,而非10倍;2030年的供给取决于更广泛的产能扩张。 开场一位未具名的Intel发言人称,AI需求“轻松高出我们最大产能40–50%”。Dwarkesh指出,ASML每年生产的EUV设备不到100台,并称到本世纪末,设备产量大幅提升的计划有限。被问到全球设备是否足以将先进制程晶圆产量提高10倍时,Pushkar Ranade回答:“ …
- Ranade认为,Intel在技术上与TSMC只差几个百分点;规模和执行仍是重要短板。 他表示,在性能、功耗或密度上相差几个百分点,“就是吹毛求疵”,更重要的是按时交付,以及良率能否支撑快速爬坡。他反驳了Dwarkesh引用的SemiAnalysis对14A与N2的对标结果。Dwarkesh称,TSMC先进制程晶圆出货量超过Intel的3倍,资本开支约为500亿美元 …
- High-NA EUV是否有价值,取决于芯片架构,而不是单纯比拼设备。 Chris Auth解释,Intel的背面供电放宽了部分正面布线间距要求,因此High-NA对Intel有用;TSMC在没有背面供电的情况下采用更紧密的间距,需要用EUV进行双重图形化。“对他们来说用处不大,对我们来说很有用。”Intel的10nm经历——原定2016年推出 …
- 更远期的3D结构是一种可能性,热管理则是限制因素;这不是对2045年的确定预测。 Auth谈到让晶体管在互连结构中悬浮,并探讨未来10年或20年更复杂的3D结构能带来什么。他认为散热是3D器件的限制因素,同时指出系统层面的分析和仿真工具仍处于起步阶段。Dwarkesh另行提醒,技术路线图通常只能看清约4年。
- 混合键合仍有扩展空间,但最密集的未来应用尚属设想。 Tyler Osborn列出互连间距的变化:15年前第一级互连为130–150 µm,如今Foveros大规模量产达到25 µm,研发中的方案已低于10 µm。他提到,今年IEEE ECTC上发表的一篇论文给出了0.45 µm间距器件的可靠性数据。他表示,更细间距的键合未来可能连 …
- 成本持续上升,正在促使这个风险厌恶的行业提出激进问题。 Ranade表示,晶圆厂成本每4–5年翻一倍,一台High-NA扫描仪加配套设备约需4亿美元。他质疑图形化成本能否继续以这一速度上涨,并问:“如今真的还需要洁净室吗?”他说,没有哪家现有厂商愿意尝试让人进厂吃汉堡、抽雪茄。Kevin Fischer的行事原则是:“如果你非要等一套 …
10月16日
10月15日
10月10日
- Pat Gelsinger AI 压缩逻辑设计的速度快于把设计变成量产芯片的流程,价值因此转向制造、封装、内存、电力、散热和机架级集成。 Gelsinger 的判断是:「不再是一颗芯片,而是一整机架」(it’s no longer a chip, it’s a rack):3个月的设计可能要面对9个月的硅片制造,再加上3个月的先进封装;他后来还称,scale-up 和软件部署大约需要18个月——足以让目标工作负载发 …
- The a16z Show 约100家 AI 处理器厂商构成的是过渡性繁荣,而非可持续的市场结构。 Raghu 认为这一数字在历史上前所未有;Guido 预计行业会整合,因为工作负载将超越今天对 prefill/decode 的专门化,成功的硬件需要巨额资本和软件投入,而大客户实际上会决定谁能胜出。Gelsinger 也认同行业可能整合,但认为由智能体生成的优化内核,可能让部分 …
- 光学互连应在2028–2029年前后取代 scale-up I/O 中的铜,但不会进入核心计算—内存复合体内部。 Gelsinger 认为,现在「让铜在5米距离上工作,成本已经高于让光学在100米距离上工作」;剩余障碍是激光器、散热、封装和尚未成熟的供应链,而非基础物理。Guido 表示,可预测的 AI 流量也可能推动光学电路交换,取代原本为未知目的地设计的分组网络。
10月7日
10月3日
- Vikram Sekar 训练仍是统一集群问题,而推理正变成一片“狂野西部”。 从72块GPU、约200 kW的 Blackwell 机架走向144块GPU,意味着功耗超过400 kW,同时冷却和网络难度进一步上升;如果再把576块或1,152块GPU分散到多个机架,连接距离就会超出铜缆的能力范围。推理则缺乏同样的秩序:混合专家模型会从不同位置调用不同权重, …
- 短期内,扩展规模的技术路线越来越偏向光互联,因为铜缆正在逼近物理极限。 铜缆在机架内部可以支持200Gbps,但无法跨越8个机架、约10米的距离;到了400Gbps,Vikram 认为它“已经彻底失效”。共封装光学可以在降低转换功耗的同时提供传输距离,但对于包含100,000块GPU的系统而言,可靠性、替换和大规模部署仍是问题。
10月2日
- Walter Goodwin Goodwin 认为,今天 AI 芯片的多样性,很多只是品牌包装下的架构相似。 NVIDIA 和 AMD 的 GPU、云厂商 ASIC 以及 TPU,普遍依赖 HBM、tensor core 和 TSMC 先进封装。Fractile 的差异化在于,试图在整条技术栈上推动创新,而不是完成前端设计后将物理实现外包。
- 公司约 150 人的垂直整合团队,旨在缩短工作负载研究、架构、物理设计、封装和晶圆厂协作之间的反馈周期。 Goodwin 认为,能否在部署中胜出,可能取决于能否结构性地锁定 3 至 6 个月的领先:“如果你能找到一种结构性锁定 3 至 6 个月领先的方法,所有这些落地都会由你赢下。”
- Goodwin 预计,即便前沿实验室开发自研芯片,也会继续向多家硬件供应商采购。 自研芯片可以带来议价能力、供应多元化和控制权,但排他性依赖风险极高:如果竞争对手在算法效率上实现 5 倍突破,实验室可能在重新设计硬件的 9 个月里陷入停摆。独立平台依然有价值,因为它们让实验室能够在模型层面竞争,而不必把生存押在单一路线的架构上。
10月1日
9月30日
- Yannick De Koninck AI 的下一个瓶颈是连接 GPU 的网络,而不只是 GPU 本身。 模型已无法装进单个 GPU,智能体系统还会在服务器之间发起对延迟敏感的调用;Yannick De Koninck 表示,这要求网络“更扁平”、连接更密集。他最有力的判断是:AI 工厂约一半由 GPU 构成,另一半则是连接这些 GPU 的技术。
- Sourcery 可投资的稀缺性横跨整个制造链条,而不只在光子学本身。 TSMC、GlobalFoundries 和 Tower 已投资硅光子晶圆,但“如果你把一片晶圆交给 NVIDIA,那并不是它订购的产品”——NVIDIA 要的是最终芯片,而最终芯片仍需要激光器、设备和衬底。吞吐量和良率仍然不足,原材料供应集中在少数供应商手中,东西方供应链割裂又 …
- Herwig Van Hove NVIDIA 的加码把一场预期已久的转型变成了眼下的产能问题。 Van Hove 将需求冲击追溯到 ChatGPT 于2022年11月爆红,随后 NVIDIA 在2024年和2025年释放更强信号,并于2026年投资 Lumentum 和 Coherent。他称 NVIDIA 在当年前6个月投入的资金相当于整个市场规模的4倍,这揭示了供需错配 …
- Sourcery Themaa 正利用收购的一家欧洲晶圆厂,将新设施建设压缩到2027年投产、2028年全面爬坡。 该工厂距 imec 20公里,既有现成基础设施,也具备光子学和工业人才。客户要求的产量已经超过 Themaa 所谓“极其激进的预测”,但设备可得性、机器性能和衬底仍是约束。
- 欧洲的光子学机会确实可信,但真正的考验在执行文化。 比利时拥有异常深厚的研究密度——Van Hove 称,2000年至2015年,根特大学贡献了全球4,000篇光子学同行评审白皮书的35%——但欧洲并未持续地在本地将自己的创新商业化。Themaa 希望将这一技术基础与快速试错、果断决策的运营文化结合起来,部分参照 De …
9月29日
9月25日
- P Equity Research 如今的算力短缺,本质上是芯片、内存、封装、电力和建设环节共同构成的复合约束。 CLSA预计ASIC/GPU的供需缺口将持续到2030年、达到73%;B200/B300租赁价格据报已从约5美元涨至每小时7-8美元,甚至已有10年前的 Volta 硬件仍在发挥作用。但嘉宾认为能源“可能是最严重的瓶颈”,并提到数据中心延期和政治阻力。
- 更不显眼的供给约束位于ABF载板、印刷电路板以及可能的磷化铟,网络设备也在拓宽这条交易主线。 ABF产能在2028年之后仍可能受限,网络资本开支未来5年或以约64%的年复合速度增长。这些约束让交易逻辑不再局限于GPU;与此同时,成熟电力设备公司的订单簿已经排到2030年以后。
- 铜和光学的共存时间,可能比光学多头预期的更长。 近封装光学器件可能在2027年开始规模化应用,共封装光学可能在2028-29年放量,但散热、良率和成本因素可能将CPO成为主流的时间推迟到2030年之后。面对不断飙升的内存账单,超大规模云厂商希望“尽可能多地使用铜”,但最终“没有什么比光传播得更快”。
9月23日
9月21日
- Bubble boi Bubble boi 的可投资判断是:AI 的硬约束正从晶体管缩放迁移到封装、互连和内存。 Moore’s Law 曾经大致承诺每2年将晶体管密度翻倍;如今投入数百亿甚至上千亿美元,可能只能换来15–20%的提升。替代方案是扩大芯片面积,让多颗裸片保持一致协同:“无论如何都要获得更多晶体管。”
- NVIDIA 的路线图越来越依赖它无法控制的供应商和技术。 H100 使用一颗大裸片,B200 转向2颗,Rubin 默认使用2颗,Ultra 设计原本计划达到4颗;但据称封装困难反复出现,最终规格下调为每个封装2颗裸片、通过2个封装实现。“我每次看 NVIDIA 的路线图,脑子里只剩一句话:今天根本做不到。”
- AI 硬件如今必须按机架级系统设计,而不是孤立的加速器。 NVIDIA 的 NVL72 连接72个封装,使用大约4颗 NVLink 交换芯片;据称 TPU 团队则把扩展域拉到9,600颗芯片,并将路由逻辑直接嵌入芯片。“这些系统已经不只是芯片”;架构现在横跨计算、网络、内存、prefill 和 decode。