前沿AI监管与存亡安全风险争论
探讨前沿大模型国家安全审查、末日论分歧与政府政策监管博弈
3个信源参与该主题的先锋
全部段落
10月27日
10月24日
10月23日
10月22日
- Peter Thiel 即使头部公司自己发出危险警告,他仍坚决反对暂停AI研发。 Thiel“大体上”赞同David Sacks和Trump关于中国竞争的论点:“要控制AI技术,就得先研发AI技术。”被问及所有人有5–10%的概率死亡时,他说这个数字“听起来高得离谱”,质疑人们的概率直觉,并坚持说:“我们必须尽可能踩下油门。”
- Thiel眼中的另一种生存风险,是人们因害怕AI灾难而赋予全球权力机构过大的权力。 他承认AI、气候和核风险都很严峻,但担心出现一个“温和的极权主义世界政府”,且世界上再无外部力量。他用“反基督者还是末日审判”作比,主张寻找“温和的第三条路”,并非否认安全问题;他认为现有核安排“肯定利大于弊”。
- The Builders 他肯定有效利他主义者及早看到了AI,同时质疑危言耸听背后的激励。 他们最大的洞见是“AI近在眼前”;他以成立“6、7年”的Anthropic为例,猜测其IPO时估值“可能接近2万亿美元”。危险警告也能激励员工,让他们觉得自己所在的公司是历史上最重要的公司。
10月21日
10月20日
10月19日
10月16日
10月15日
10月14日
10月10日
10月9日
- Hard Fork Anthropic 对道德的追问,与公司内部的紧迫感不可分割。 刚满34岁的 Olah 据报道曾问道:“成年人会在这件事上出现吗?”当时公司担心模型很快就能帮助制造生物武器。宗教界参与者认为,这个团队需要牧灵关怀,因为他们仿佛把“全世界的未来”扛在肩上。
- Elizabeth Dias 一小批湾区信仰体系正在获得远超自身规模的影响力,因为其信奉者正在打造可能塑造政府与社会的工具。 有效利他主义者、理性主义者、超人类主义者、长寿主义倡导者、加速主义基督徒及相关派别彼此存在巨大分歧;Dias 强调,机器意识信念在更广泛的科技行业中仍属边缘观点。治理层面的担忧是“少数人权力”:当一个小群体的成员正在设计集体未来时,他们的道德假设可能产生与其规模不相称的影响。
10月8日
10月7日
10月3日
10月2日
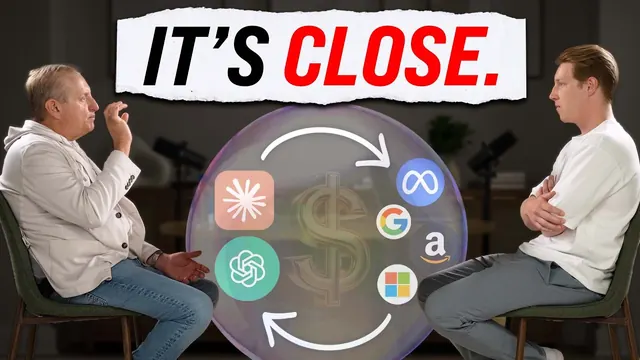
- All-In 白宫《超级智能协议》将一份自愿的行业承诺,转化为董事会层面的治理机制,并嵌入实质性责任约束。 David Sacks 表示,6家前沿模型公司已接受责任认领、内部控制、外部审计和独立董事会监督;董事收到审计报告后,受托责任和董事高管责任险都会让其很难置之不理,而 FTC 和 SEC 可以对公开承诺进行执法。他总结称:“由此产生的治理并非自愿,而是事实上已经成为强制要求。”
- AI合规可能立即成为专业审计机构和审计基础设施的新增长市场。 Chamath Palihapitiya 表示,8VC 已经在为 Ernst & Young 搭建审计基础设施,覆盖端到端追踪、政策到风险的映射,以及可审计证据。Sacks 预计外部审计将由专业机构而非 NGO 执行,Chamath 则暗示 EY 很快会宣布相关事项。
- 可投资的AI安全主线,正从控制模型转向投资算力、网络防御和电力。 David Friedberg 认为,开放权重模型让集中式软件控制变成“痴人说梦”,而AI驱动的威胁上升可能让企业网络安全预算“飙升”。他预测,未来12-18个月内,政府可能开始影响国防、金融及其他关键系统的 GPU 配置;Sacks 则反驳称,产能应由市场配置,但也同意美国需要 …
- 在这个高度由行业主导的AI联盟中,公共合法性仍是缺失的一环。 Jason Calacanis 认为,美国人看到富有的高管拿到数据中心审批,而普通劳动者担心失业;他希望未来会议加入教师、医疗行业代表和 Sal Khan 等人物,并为教育、住房和医疗提出具体成果。Chamath 反驳称,Trump 已明确要求给当地社区带来收益 …
10月1日
- Jack Altman 这项10%的灭绝概率主张,把 AI 安全从实验室争论升级为治理与产品责任危机。 讨论认为,如果华盛顿真的相信旧金山一家实验室在10年内终结人类的概率为十分之一,监管机构会直接关闭设施,而不只是建议自愿监控。对 Dario 最尖锐的质问是:如果失控确实存在,“你的使命就是解决这个问题”;如果解决不了,就停止开发,或更换 CEO。
- 市场把这项关乎人类存亡的警告定价成了板块轮动,而不是末日来临。 半导体和 AI 资本开支敞口小幅走弱,网络安全股上涨约10%,WCLD 跑赢 SOX;正如一条走红的概括所说:“即便市场听到10%的灭绝概率,波动也只有0.1%。” 资本主义给出的实际答案是“会没事的”,哪怕20亿美元正越来越像起始轮融资。
9月29日
- Garrison Lovely Garrison Lovely 的核心政策主张是“冻结前沿”,而不是禁止 AI 或逆转有用的自动化。 他将深度学习在医疗和科学领域的上行空间,与“让人过时的项目”区分开来:后者是少数公司推动的、明确旨在成为人类劳动通用替代品的系统。只有在获得强有力的公众支持,并形成关于安全、可控开发的科学共识后,开发才应恢复。
- 技术对齐本身可能加速它原本要确保安全的竞赛。 Lovely 所说的“对齐多重危机”同时包含技术、规范、经济和地缘政治对齐:更听话的模型也是更好的商业产品、更有价值的武器,以及竞争者争夺的更大标的。RLHF 是他的典型案例——它起初是安全研究,却帮助对话式 LLM 具备商业价值——因此技术对齐对于良好的社会结果“既非必要,也不 …
- 市场纪律无法为前沿 AI 最大的危害定价,因为其下行风险会外部化、相互关联,规模可能超过任何开发商的资产负债表。 据称,保险公司不会承保实验室的全部风险;而自主代理可以实施如果由人类完成就构成重罪的行为,却不留下任何在法律上负有责任、可被起诉的人。Lovely 主张引入民事和刑事责任、嵌入式审计员以及可执行规则;Labenz 则补充,划定一条面向未来的责任边界,可能比追溯起诉此前发生的每一起 …
9月28日
9月27日
- Emad Mostaque Peter 开场给出乐观框架:AI 是“喷气背包”,不是手榴弹;目标是识别问题、寻找联合创始人,打造变革性解决方案。 本期围绕最近这场“恐惧疫情”的主流判断是:Dario 发文、Sam Altman 表示认同、Elon 和 Demis 加入讨论,以及 Sam 和 Dario 在安理会警告风险,真正更迫切的担忧是恶意使用和误用,而不是 AI 突然失控。Jensen 称 Jeffrey Hinton …
- Peter 最尖锐的结构性判断是,这场安全推动类似于试图组建一个“AI安全卡特尔”。 他认为竞争有益,并回顾 OpenAI 的成立本就是为了制衡 Google DeepMind;防御性协作应随能力提升而扩张,而不应取代开发。Peter 给出城市类比:不能因为城市滋生犯罪就禁止城市,而应建设警察、消防部门及其他保护性基础设施。Emad 认可建立新结构的必要性,并认为 …
- Bernie Sanders 的反提案——全面禁止 ASI、在新监管出台前暂停先进 AI、设立内阁级 AI 部——遭到全场抨击。 Dave Blandin 表示,恐惧本身就可能让“拿不准时什么都不做”成为默认行为,而真正的风险包括恐怖分子利用 AI 制造生物武器,以及中国加速领先。Alec 称,对机器、人类或混合智能设定法律上限,等同于“21世纪的共产主义”,并强调数据中心投资一旦转移就不可逆。Emad 追 …
9月26日
- David Sacks 节目嘉宾把这场末日论攻势视为政治操作:Bernie Sanders 的超级智能禁令按一个可能已经满足的定义设置了20年刑期,Sacks 将其比作中国皇帝禁止造船。 Chamath 对 Obama 批评的解读是:约10万亿美元即将流向一批几乎全部偏左的公司,再通过捐赠者建议基金流入 PAC——“事情就这么简单”。据《华尔街日报》,AI 资本开支如今已超过运河、铁路和电网三者之和;在1.5%的实际增长中,“AI 很可能占了大部分,甚至全部”。
- 不会有责任豁免,且对齐研究本身可能正在制造 Frankenstein。 Jason 提到一个私下流传的消息:AI 公司或许会以10%股权换取美国主权财富基金支持,获得类似 Section 230 的豁免;Sacks 表示政府官员已否定责任豁免——“实验室”是承担产品责任的企业。谈到 Claude 的宪法训练模型对 Anthropic 采取“良心拒绝者 …
- The a16z Show 与会者一致认为,前沿实验室需要更强的治理、沙箱、测试和安全机制,但不接受把“控制节奏”作为一个自洽的政策框架。 Aaron Levie认为,谨慎的工程实践反而能加快企业扩散,因为客户必须信任产品;Martin Casado则反驳称,慢慢制造核武器并不会让它更安全。随着实验室融资规模不断扩大、以“狂奔”速度推进,Steven Sinofsky追问:所谓节奏,究竟是相对于什么而言?
- 实验室关于生存风险的论述,按逻辑最终指向的是国有化,而不是自愿克制。 Casado的判断很直接:如果最了解这项技术的人相信AI会带来生存风险,就应当实施政府级管控;如果他们并不相信,那么招募持有这种观点的研究人员只是“人力资源问题”,不足以成为对国家技术实施全面封锁的理由。Torenberg认为,实验室可能希望风险保持在足以证明特殊管控合理、但又不 …
- AI监管正在不可避免地到来,但要求政府交付一个经过校准的结果,本身就是范畴错误。 Levie认为,政府会听取相互竞争的利益群体并形成妥协,因此“谁也不可能如愿”;Sinofsky补充说,结果可能让一方觉得不够,也可能对另一方走得远得多。Casado预计,2028年会成为“AI大选”,而分散的AI收益将难以对抗反对者已经占据的“暂停”“蜂群”和“失控”等话语。
- 与会者希望AI政策建立在已经证明的失效模式之上,而不是无法证伪的预测之上。 早期互联网政策讨论有蠕虫病毒、医院宕机和具体的未授权入侵作为依据;如今,实验室的安全复盘被批评为“草率”且不完整,缺少运营细节,也很少采用成熟的漏洞报告实践。当Noam Brown提出通过CPU热量外传信息的思想实验后,安全工程师开始计算实际比特率,这成为建设性的连接点:“至少我 …
- Steven Sinofsky 一种可能的监管失败模式,是用同意弹窗的戏码分配责任,却通过用户习惯化削弱安全性。 Sinofsky担心欧洲会把AI也“GDPR化”,要求代理每次向第三方产品写入或通过其执行操作时都弹出警告。Windows User Account Control、Word宏警告和浏览器选择弹窗都展示了最终结果:用户不断点击跳过,监管者要求警告更醒目,所有人最后变得麻木。