具身智能与机器人量产商用
讨论通用人形机器人泛化能力、训练数据及量产商用路径
3个信源参与该主题的先锋
全部段落
10月26日
10月24日
- 王淏楠 淏楠更看好“大模型大脑+自有硬件与小模型”的具身分工。 他形容具身厂商与大模型厂商的卡量“差俩零”,创业公司更现实的壁垒是硬件与 System 一起 co-design,以 7B—16B 模型控制本体,再接外部大模型。真机数据仍重要,尤其灵巧手要完成的动作细节,很难由粗糙仿真替代。
- Astra 最重要的潜在价值,是接管失败步骤并推动采数闭环。 淏楠设想,小模型在陌生场景已有 50%—60% 成功率时,由 GPT 接管失败、留下 error recovery 数据,再把成功率从 60% 推到 80%,最终可能让一名遥操员看十台机器。他认可只学习接管步骤的“软蒸馏”;全程依赖大模型输出机械转角,则“太慢了,太费了”。
- 具身的高估值仍要靠真实场景兑现。 曲凯以最高估值约 200 亿元、账上约 50亿—60亿元的量级追问,淏楠给出的落地例子是酒店叠被子:地面平,可以用轮式机器人,环境又介于标准与非标准之间。他转向 physical AI 是长期职业偏好,但对行业的要求很直接:“真的落地,真的能够有场景。”
10月21日
10月19日
10月17日
- Emad Mostaque 前沿 AI 模型完成一项实体机器人的子任务,成本在2个月内下降84%——YC 创业公司 RoboCurve 的 RoboDojo RC Tier 1 基准测试显示,成本从7月的2.36美元降至9月的0.38美元。 嘉宾讨论了任务成本每3周减半的趋势;Peter Diamandis 认为,照此发展,机器人智能或能在1年内几乎变得零成本。Emad Mostaque 提到,Unitree CEO 曾质疑是否还需要专用机器人模型;嘉宾也讨论了通用模型如何将价值推向硬件和机器人供应链 …
- 随着模型成本下降,机器人的硬件和供应链可能成为瓶颈。 Salim Ismail 认为创业者应该生产机器人、执行器和备件。Figure 的 Brett Adcock 已承诺投入10亿美元用于数据,Diamandis 预计基础模型公司也会寻求机器人数据;Mostaque 表示,机器人数据规模比语言数据大一个数量级。Diamandis 称 …
10月15日
- Lindon Gao Dyna创始人Lindon把公司定位为“Product Research”派,自称“全战派”。 他强调用产品闭环引导research方向:任务级落地不等于商业闭环,“机器人需要保姆这件事情是一个非常大的产品问题”。他去年决定不继续scale已有十余客户的折叠业务,转向“一个员工”战略——机器人24小时产出达到一个人8小时的产出;他说目前已经超出这一目标。
- 技术路线上Dyna押注ego-centric第一人称数据,称在100万小时级预训练集上发现了“非常强的scaling law”,并从重视高质量数据转向追求更广泛、多样的数据。 Lindon承认自己曾选择性听取LLM从业者的ablation结论来强化“all in high quality data”的判断,后来认为应先从更广泛的数据中找到可scale的部分;他认为押注teleop、UMI等形态,某种程度上是在押注机器人手不能work,而机器人手是工程问 …
- 商业判断的反共识:他认为B2B通用机器人的需求会大于B2C家庭机器人;家庭是机器人很难、很远的产品方向,不是当下的首战场。 他的论证是:美国失业率4.5%意味着企业雇用了95.5%的美国劳动力;按三人家庭估算,家用机器人可能只需约一亿台,而企业对产能的需求还会扩大。首个落地场景选酒店洗衣房——他称美国有10万家酒店、每家洗衣房需要2–5人,TAM有好几个billion;并把洗衣房称为通往home的“最 …
- 对“大脑vs本体”的判断是“大脑是机器人的下限,本体是机器人上限”:大脑决定能不能做,硬件和运控决定做得多好。 他认为十年维度供应链可能更重要。Dyna在中国有四五十人的硬件研发和供应链团队,工作流机器人已进入百台级别的初步量产;上一代没有量产,因为他认为它本质上跑不通。
- 对自家产品和战略方向,他估计距离可规模化的产品价值还有一到两年;他认为未来一两年行业可能进一步收敛。 他用GPT-3(2020年6月,API形态)到ChatGPT(2022年11月,聊天产品形态)说明产品形态不可忽视,并预告明年会展示下一步产品;他认为机器人不必先达到physical AGI,产品定义和使用方式同样重要。
10月14日
- 陈哲 本季度最大的冲击是 GPT-6 Astra 展示了通用模型进入物理 AI 的能力:前沿实验室倾向于先解决 AGI,再把 physical AI 当作子问题。 Astra 不只做任务拆解,还能直接输出末端执行器位姿,经逆动力学转成电机信号——这一步以前被认为属于具身模型。开源社区复现显示,相较 Claude 成功率显著提高;曼祺还提到,另有 Robot Dojo 对比中 Astra 的成功率高于部分顶尖具身模型。“没有见到神迹的人就是不 …
- 陈哲把 Astra 的影响分成三层:直接做策略、监督纠偏 VLA、以及最“头皮发麻”的——充当机器人学研究员。 银河通用的案例里,Astra 直接控制 10 个 Robot Dojo 任务成功率为 26%,监督 π0.5 输出则升至 48%;第三层设想是让它在 Blender 里搭仿真环境、生成物体和属性,并调试运动控制策略,“在物理世界里 AI 可以自己训练 AI”。陈哲认为 …
- 陈哲预计所有头部通用模型公司都会采取机器人领域的动作:Kimi、智谱有相关传闻,梁文锋提过物理 AGI,字节 Seed、腾讯 RoboticsX 等团队也可能按生成式 AI 的思路调整。 算力差距仍很大:头部具身公司 GPU 规模可能是千级,头部通用模型公司是十万甚至百万级,差两到三个量级。一位 Frontier Lab 的朋友也提醒,基于其数据量和算力得出的推导“对绝大部分创业公司并不成立”。
- GEN-1.5 与 S1 展示的具身 ICL 能力,可能把部署所需的后训练压缩为分钟级示范视频。 两个出人意料的发现是:分布外任务可能通过一次示范学会;长序列技能组合(如打包、搬运)也能通过视频示范传授。行业逐渐形成的看法是,架构未必最关键:给 VLA 和 WAM 同样质量、规模的数据,都有可能训练出同样好的策略模型。
10月13日
- Jason Ma Dyna Robotics拿出了许多机器人初创公司尚缺的一项商业化验证:多地点、经客户验证的规模化部署,而非试点。 它的机器人已在多家鼎泰丰门店每天折叠数千张餐巾,也为Best Western折叠洗衣物。Jason称,鼎泰丰签下了一份大得多的合同,并在考虑将切食材作为另一个应用场景;但访谈并未证明切食材已纳入合同。他的说法是:“真正难的是让客户验证,机器人的价值足够大,值得在旗下多家门店部署 …
- Vibhu 任务适配所需的机器人数据采集时间,从几十分钟到一两个小时不等。 切菜任务用了45分钟;开冰箱则是工程师入职面试中的任务。Vibhu说,新机器人自身数据不多,却能迅速学会任务,关键在于硬件尚未就绪时就先用人类数据预训练。机器人的身材比例也参考了人体,以改善迁移效果。
- Dyna 2.1被定位为搭载“物理智能体执行框架”的硬件平台,能够支持更长的工作流程。 Vibhu称,完整洗衣流程约需1小时,并认为机器人真正的价值在于连续数小时无人值守地完成工作。演示片段展示了洗衣流程的部分环节,旁白称完整流程之后才会发布。公司的演示旁白将目标描述为让机器人“成为工作场所的一名完整员工”(a whole employee at a …
- Dyna走全栈路线:自建推理栈,并在推进执行器自研,同时打造带轮式底座和4自由度腰部的半人形硬件。 Vibhu称,腿式设计在能耗、稳定性和安全性上存在取舍;与其花5年或10年打造最终形态的仓库人形机器人,不如先用半人形产品与真实客户迭代。谈及供应链,Jason称磁体是瓶颈,只有2个国家生产;Vibhu提到稀土材料,Jason则表示不清楚具体化学成分或材料。Vibhu补充说,没有 …
- Jason Ma 部署目标是目前已有数十台机器人,明年达到数百台,长期愿景则是数百万台。 Jason警告称,“机器人公司有一大片坟场”,里面满是演示亮眼的产品;只专注问题一部分的团队可能陷入“战争迷雾”,做出看起来很厉害、却不是客户所需的东西。
10月7日
10月3日
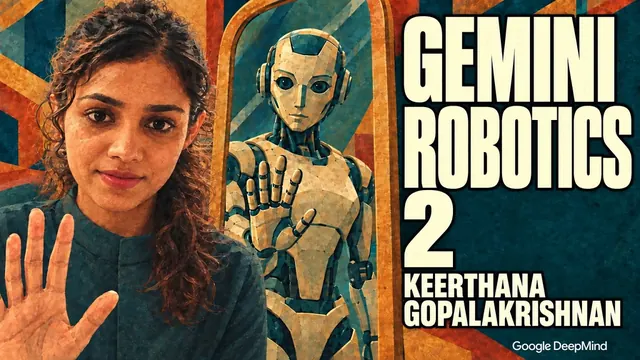
- Keerthana Gopalakrishnan Keerthana 认为,中国走红的机器人奥运会确实展示了运动能力的进步,但并不是衡量机器人近期实用性的好指标。 在平坦、坚硬地面上奔跑对仿真尤其友好,而真正有用的操作能力会在接触、摩擦、可变形物体和不可预测环境面前迅速失效。她的直白校准是:“我的很多朋友效率很高,但我们跑不过 Usain Bolt。”
- 机器人仍处于“GPT-2 时刻”,因为令人印象深刻的演示还没有变成可迁移、可靠的智能。 要达到 GPT-3 级别的进展,模型需要从多个任务的多个样本中学习,并拥有一个能够跨越人形机器人、机械臂和其他身体形态迁移的大脑;如今,能力仍高度依赖具体机器人和具体设置。单次模仿很有前景,但复制演示并不等于场景变化后仍能泛化。
- Gemini Robotics 2 通过3个模型,将具身推理与物理执行拆开。 Gemini Robotics ER2 是负责更高层级、调用工具的“大脑”;Gemini Robotics 2 是控制运动的视觉-语言-动作模型;Gemini Robotics On-Device 2 则是更小的本地版本。这一架构让大模型负责理解意图、专门的动作模型负责控制身 …
- 受控的商业环境仍最可能成为早期部署切入口,尽管在家庭场景中,模型延迟可能没那么重要。 Nathan 强调可重复的工厂、仓库任务和专业服务;Keerthana 也认同,商业使用场景比家庭更容易控制。在传送带上,6秒停顿不可接受;但如果机器人彻夜叠衣服,慢6秒并不重要。Keerthana 预计,快模型和慢模型会同步发展,大模型获得的能力将逐步迁移到更小的模型中。
- 跨身体迁移正在快速改善,但“一个大脑,任何身体”仍是愿景,而不是已经解决的能力。 Google DeepMind 的模型如今能够控制从“指尖到脚”的人形机器人,其端侧项目据称只需约200个样本,就能让任务适配新的身体。但 Keerthana 认为,目前几乎没有先例能让一种全新的身体形态在完全零样本的情况下,可靠性极高地执行大量任务。
- 硬件进展速度超出了 Keerthana 的预期,剩余工作正转向可靠性、可重复性、成本和安全的力控制,而灵巧手正逼近能力瓶颈。 在大约1年3个月内,前沿能力已经从夹爪推进到多指控制、系垃圾袋和全身操作。她说,Shadow hand 可能可以举起约20公斤。商业化剩余工作,是让机械手具备可重复性、耐用性和可负担的成本,并能在精细物体和人类身边安全工作。
10月1日
9月29日
- 熊友军 熊友军把人形机器人运动会定义为极限测试场:比赛不是替代工业落地,而是在统一标尺下摸出本体、能源、运控与可靠性的天花板。 天工 Omni 从彩排的 9 秒 44 迭代到 8 秒 64,背后是竞争密度对软硬件极限的持续挤压;真正的商业门槛则更苛刻——工厂要求 7×24 小时运行和甚至 99% 的成功率,“板凳要坐十年冷”。
- 爆火的“无脸跑”不是预编程表演,而是机器人在肩关节受限、功耗受约束的条件下,为追求最快速度自行找到的解。 团队一度嫌姿势“不那么漂亮”,甚至想重训,但最终保留了最快版本:机器人舍弃摆臂、改用腰部扭动平衡下肢。熊友军将其视作一种具身智能“涌现”——“它确确实实是自我学习、自我进化的一个结果”。
- 运动会最重要的年度变化不是速度,而是自主化:去年 200 多台机器人中只有天工全自主参赛,今年除部分障碍项目外,田径机器人基本摆脱了遥控器。 熊友军认为这只是“大脑进步的一个展示”,因为识别跑道、压弯和调整跑姿仍是较浅能力;长程规划、错误反思和环境突变处理,比赛尚未充分呈现。
- 具身智能的数据需求很可能达到千万小时量级,但熊友军拒绝把“大力出奇迹”当成确定终局。 当前通用运动控制器只用数百小时人类数据,世界模型训练约几万至几十万小时,与千万小时仍差数个数量级;他承认“我们现在都还不知道”scaling law 的天花板,并判断纯靠堆数据“可能不一定是一个正确的方式”,自主探索、强化学习和少样本学习仍可能改写所需数据规模。
- 真正训练“机器人大脑”的门槛同时来自算力、数据和范式,而不是发布一个模型名称。 熊友军认同“千卡有效算力”是一条有意义的判断标准;创新中心借助百度及多家云平台训练,年采集量接近 20 万小时,开源下载超过 2,000 万次,并把重点从重复的抓取放置转向长程任务、逻辑链、力觉触觉、失败与反例。“数据驱动”仍能落地,但 VLA、世界模型、多模态与大一统模型都尚未 …
- 近期商业化仍将首先发生在结构化工业场景,但这更像通往家庭机器人的桥,而不是终点。 包裹分拣中,人类最快约 2,000 多件/小时,FANUC 被提及约 1,500 多件,国内机器人约 1,000 至 1,400 件;差异来自本体、算法、模型、数据与场景定制的综合能力,至少在 WRC 展示中尚未出现明显代差。熊友军坚持人形最终会成为“朋友、伙伴,甚至家人”,主持 …
9月20日
- 徐梦迪 徐梦迪称已在具身领域看到 Scaling Law 的早期信号,但强调 loss 不等于成功率。 他援引其他公司的结果:预训练数据从十万小时 scale 到一百万小时后,在未见过的测试集上有较好效果;但他用“拿杯子二十步、前十七步可能都没有接触到杯子”的例子说明时序不平衡让 loss 与 success rate 脱钩,他真正想见的是“数据逐渐增多、模型逐渐变大,你在没有见过 …
- 他判断具身当前处于 GPT-1 阶段(预训练+针对 target domain 的 fine-tuning),押注的拐点是 GPT-3 式的 in-context learning 时刻。 终局是终端用户用 prompt 和 demo 定义机器人行为——叠衣服可以叠方块、卷起来或只挂不叠;他判断未来三到五年可能通过 scaling 看到一个明确的范式转变或拐点,而这场马拉松目前只“跑到十公里”。
- 对中国具身创业的整体判断:“有非常多实际的进步,但也会存在一些泡沫,两个其实不是互斥的。” 材料、sensor、本体、数据、模型全链条都有国内公司攻关、资源持续投入,长远他“非常乐观”;但行业焦点从数据摆到世界模型再摆回数据,他类比控制系统的“超调”震荡——路线远未收敛。
- 具身落地最 risky 的点是数据闭环的鸡生蛋问题。 base 模型要好到终端用户教半小时就能看到“显而易见的进展”,数据闭环才转得起来;而模型又需要先进场景被使用才能提升。目前他的团队正在真机双臂加灵巧手的桌面任务上尝试采集人类修正指示、改变机器人行为,目标是全身灵巧操作。
- 数据路线上他自称“融合派”,认为 human data 价值很高。 遥操作数据最接近本体、适合 post-training;simulation 干净可控、适合 pre/mid-training;UMI 居中;human data 成本最低可铺满场景——“人确实是一个非常成熟的本体”,morphology 差异可由 transfer 解决,学的本 …
- 方法论金句贯穿全场。 李飞飞先追问 benchmark 指标中“哪个是真正重要的”,徐梦迪的答案是最终 success rate;她又引用爱因斯坦“把事情变得简单不是更简单”。姚期智的建议是“真正重要的问题其实没有几个”;扣姐收尾:“悲观很容易正确,只有乐观才可能成功。”