大模型推理成本优化
探讨推理经济学、吞吐成本、KV缓存与端云协同
7个信源 · ↑1.1×参与该主题的先锋
全部段落
10月27日
- SemiAnalysis Anthropic披露的经营数据,正在挑战前沿模型推理依赖补贴的看法。 Joey提到,公司已连续2个季度盈利,利润率超过10%,推理毛利率为85%,算力毛利率为41%。Jeremie则强调90%的毛利率和潜在的40% EBIT利润率,但前提是“如果他们能做到”: “你卖1美元的东西,只收10美分。”
- 算力效率提升改善了Anthropic的经济性,但嘉宾对其中有多少应归功于公司本身看法不一。 Joey称,单位兆瓦推理收入已从1600万美元升至超过6000万美元。Doug追问,这其中有多少来自Anthropic,又有多少源自整体硬件进步;Jordan和Doug强调软件、加速器多元化以及模型辅助工程的重要性:“模型才是差异化所在。”
10月26日
10月24日
10月23日
10月22日
10月21日
10月20日
10月19日
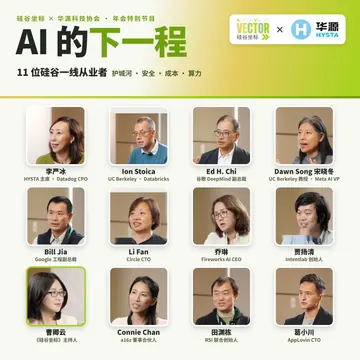
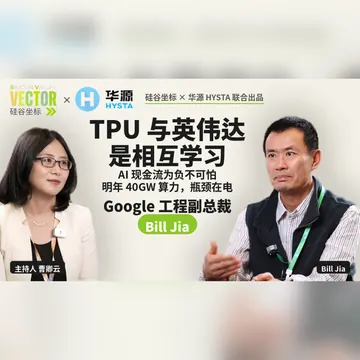
- Bill Jia 针对主持人关于谷歌 balance sheet 为负、CapEx 与收入错配的担忧,Bill 提到三条降本路径:模型提高 intelligence、减少 FLOPs;软件持续优化 networking、memory caching、compute 等;硬件本身也可以更便宜。 他认为,持续优化后最终可以实现 positive cash flow;如果继续优化,暂时的 cash flow negative 不用怕。
- 创业机会方面,他概括说会看 devices,以及能高效、可扩展地做事的 agents;具体到 inference,他会投资开发推理优化 agent。 模型与硬件的 N×M 组合很多,靠人力逐一优化“very, very unscalable”,而 agent 可以更便宜、可扩展地优化 performance、reliability 和 scalability。大厂也会做,但创业公司有时能做得更快、更好。
- Bill 认为推理算力长期会占更大比例,当前是否五五开“很难说”,推理有可能已经超过 training;若现在五五开,长期可能走向四六、三七、二八。 Agentic era 下 memory 仍会很短缺,CPU、flash 和 hard drive storage 的需求也会上升。
10月18日
10月17日
10月16日
10月15日
10月14日
- Wenyao Gao GLM-5.3 发布数周后,AMD MI355 已在推理成本上向 NVIDIA 发起挑战。 Wenyao称,单用户速度达到每秒150 token时,成本大致追平 B200;Jordan还提到,MI355 单用户速度达到每秒100 token时的吞吐表现。InferenceX数据显示,“红色 AMD 曲线反超绿色 Nvidia 曲线”,随后 NVIDIA 又提升了表现—— …
- SemiAnalysis 极低延迟与总吞吐最大化,背后的经济账并不相同。 TailRT通过解码 megakernel,在 batch size 为1时速度最高可达每秒470 token,但无法服务大 batch。Kimbo认为,在这一场景下,内存带宽“最重要”;Wenyao则说自己不用超高速模式:“太贵了。”
10月12日
10月11日
10月9日
10月7日
- Max Kan Anthropic 的 200美元订阅,按 API 价格计算,能提供约 12,000美元的使用量,而且未必亏钱。 Max 引用了 API 毛利率超过 90% 的市场共识预测;如果平均订阅用户只消耗最高额度的约 10%,订阅业务仍可能实现 50–60% 的毛利率。更尖锐的结论是,API 定价可能属于“惩罚性、剥削性、投机性定价”,而不是每个订阅 token 都在被补贴。
- SemiAnalysis 订阅的价值不能被压缩成一个美元数字,因为不同模型和 token 类型对套餐额度的消耗方式不同。 新输入、缓存写入、缓存读取和输出的权重各不相同,因此同一个 200美元套餐,根据工作负载不同,可能对应截然不同的 API 等价价值。最稳妥的表述始终是:“某个模型上的某种工作负载”对应多少价值。
- 缓存是 Agent 推理经济学中的决定性杠杆。 测试中的 Agent 工作负载约 96% 是缓存读取;由于读取的是已有的 KV cache,而不是重复进行模型计算,其成本可能只有新输入的 0.1x 甚至更低。在不同部署、内存层级和暂停时段中维持高缓存命中率,需要大量系统工程——这“正是区分优秀推理服务商和无用服务商的东西”。
- Andrew Megalaa 在嘉宾进行的同口径 200美元对比中,Anthropic 提供的可用 token 明显多于 OpenAI。 他们测得约 19亿个 Astra token,对比 31亿个 Fable 5.1 token;但 Fable 只消耗了 Anthropic 额度的 50%,剩余一半仍可用于 Opus。尽管批评者引用 Artificial Analysis 的对比:最高成本的 Opus 5.5 任 …
- Max Kan 订阅的实际毛利率取决于普通用户的消耗远低于公开上限。 Max 认为,如果泄露的财务数据要能自洽,Anthropic 的利用率“不能高于太多 10%”,这意味着订阅毛利率约为 40–70%。OpenAI 宣布将额度上限下调 50% 后,公告前购买套餐的用户尚未受到影响,因为有 1个月的宽限期;这可能把反弹推迟到额度下降真正落地之后。
10月3日
- Vikram Sekar 面向消费者的智能体应当扩大推理需求,但不会沿着 Mac mini 热潮所暗示的那条永久专用处理器曲线增长。 大多数个人任务用 Sonnet 级别或开源模型就能完成,处理器和内存则可以共享,或在需要时即时启动。需求仍会增长,但 Vikram 警告说,“一切都会因为智能体而爆发,而这可能并不会真的发生。”
- 内存层级的优化目标应是每个 token 产生的有效工作量,而不是让所有场景都追求最高 token 吞吐。 对于上市时间至关重要的编码任务,1,000–2,000 tokens/秒和昂贵的带宽可能物有所值;而在后台读取 PDF 的智能体,则可以用更慢、更便宜的方式处理大量 token。真正的经济问题是:“每个 token 实际完成了多少有用工作?”
10月2日
- SemiAnalysis AgentX 说明,在真实编码 Agent 工作负载中,KV-cache 管理会成为决定性因素。 通过 SemiAnalysis 内部代理捕获并重放的会话显示,P50 请求接近 100,000 个输入 token,理论缓存命中率超过98%,因为每次工具调用都会向既有长对话追加内容。低并发交互场景下,DRAM 卸载价值有限;但当并发 Agent 达到数百个、吞吐在 40–60 …
- 在工作负载与定价假设成立的前提下,当前推理经济学可能让最新系统看起来像“印钞机”。 团队的计算器将硬件、电力、数据中心成本、吞吐、并发和 OpenRouter 定价结合起来;讨论中的情景包括 GB200 NVL72 约 40.7%的利润率,以及 GB300/Moonshot 在按牌价的 30%和60%计价时约 50%的利润率。结果仍高度依赖利用率、节点可用性、软 …
- 关于快速 token 的争论尚未定论,因为 Agent 工作流同时包含对延迟敏感和对延迟不敏感的阶段。 Bryan、Cam 和 Alec 认为,在多个 Agent 并行运行,或 30 秒工具调用占主导时,快速解码的回报有限;尤其当价格接近每100万输出 token 300美元时更是如此,但 Alec 也提醒未来工作流可能改变。TensorRT 在 NVIDIA GPU 上实现每秒数 …